Infraestrutura de Mapeamento
Uma arquitetura para o pipeline de dados de cinco camadas — ingerir, normalizar, enriquecer, armazenar, servir — que transforma os mapas dispersos do ecossistema da web liminal em infraestrutura computável: a base de dados por trás do tipo de mapeamento de protocolos e projetos que o Navegador da OpenHaven apresenta.
Fontes de Dados · Pipeline de Automação
1. Visão Geral
Este documento descreve uma arquitetura para ingerir, normalizar, enriquecer, armazenar e servir dados da web liminal, de movimentos regenerativos, de esforços de renovação cívica e de ecossistemas adjacentes. Destina-se a apoiar uma variedade de aplicações nas quais os usuários precisam ver mapas com dados geográficos e orientados a projetos. Uma observação sobre o escopo: este documento descreve uma arquitetura técnica e um conjunto de casos de uso. Não é uma teoria da mudança. O caminho causal da infraestrutura de dados até os resultados de coordenação exige uma camada de facilitação humana que este documento não modela completamente — essa questão é tratada nos documentos complementares listados na Seção 6.1
O próprio Navegador e a Matriz da OpenHaven — um catálogo comparativo de mais de 200 protocolos, plataformas e ferramentas em todo o ecossistema de tecnologia descentralizada e ponto a ponto — é uma das principais fontes de dados que esta arquitetura foi construída para atender, e a ilustração mais clara para que serve o pipeline. Do ponto de vista dos dados, um projeto como a OpenHaven requer dados de entidades tecnológicas (protocolos, plataformas, ferramentas e projetos com atributos estruturados: maturidade, licença, capacidades, modelo de governança), dados de estruturas conceituais (as estruturas teóricas e taxonômicas que tornam a categorização significativa), dados de pessoas e organizações (desenvolvedores, mantenedores, comunidades e financiadores) e interconexões conceituais (como as tecnologias se relacionam entre si — implementa, estende, compete com, complementa).
Lido junto com o diretório mais amplo de mapas e ferramentas pesquisado abaixo, isso aponta para um objetivo mais geral: combinar os próprios dados de matriz e navegador da OpenHaven com o conjunto mais amplo de mapas de ecossistema e ferramentas de automação catalogados neste documento, para construir os frameworks de descoberta, automações e mecanismos de conexão que um ecossistema fragmentado atualmente não possui. Levado adiante, esse objetivo aponta para algo mais ambicioso e mais distante: protocolos abertos e descentralizados que poderiam replicar parte do que os mecanismos de busca centralizados e os chatbots de IA fazem hoje — descoberta, recuperação, recomendação, conexão — sem um único ponto de controle. Este documento não é esse protocolo, e construir um seria um empreendimento genuinamente difícil, de vários anos. Mas a arquitetura de dados descrita aqui — uma forma comum de ingerir, normalizar e servir informações estruturadas sobre pessoas, organizações, projetos e tecnologias — é próxima de um pré-requisito para isso, e pode ser lida como um rascunho inicial e parcial rumo ao tipo de especificação que esse esforço eventualmente exigiria.
A base desta arquitetura é um diretório curado com mais de 60 mapas de ecossistema, fontes de dados, ferramentas de automação e esquemas de categorização, compilado por meio do projeto de pesquisa mapeamento e articulação em rede do ecossistema da web liminal, originalmente patrocinado pelo Institute of Applied Metatheory. Este documento oferece uma análise sistemática de quais itens desse diretório são fontes de dados acionáveis, quais ferramentas de automação oferecem mais valor, como isso se relaciona a casos de uso específicos, e como o pipeline completo pode ser construído e mantido.
| Enquadramento-Chave | Esta arquitetura trata os mapas de ecossistema não como visualizações, mas como fontes de dados — coleções estruturadas ou semiestruturadas de informações sobre pessoas, organizações, projetos, tecnologias, estruturas conceituais e lugares que podem ser extraídas, unificadas e tornadas computáveis. |
|---|
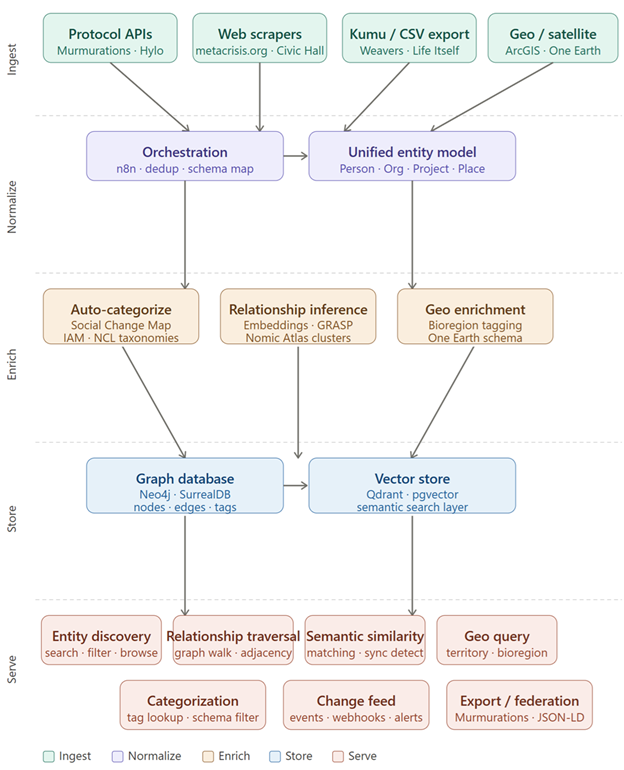
A arquitetura está organizada em cinco camadas:
- Ingerir — extrair dados de fontes externas por meio de APIs, scraping, exportação manual e captação nativa de protocolo
- Normalizar — desduplicar e mapear dados heterogêneos em um modelo de entidade unificado
- Enriquecer — aplicar esquemas de categorização, inferência de relações e marcação geográfica
- Armazenar — persistir os dados normalizados e enriquecidos em bancos de dados de grafo e vetoriais
- Servir — expor os dados por meio de funções que apoiam a coordenação cívica, o mapeamento de tecnologia, a inteligência de rede e o engajamento comunitário
O diagrama abaixo mostra a estrutura geral do pipeline.
2. Casos de Uso Centrais
A infraestrutura foi projetada para atender a quatro casos de uso que se cruzam. Compreender esses casos de uso é um contexto essencial para avaliar quais fontes de dados e ferramentas vale a pena priorizar.
2.1 Catalisando o Engajamento Cívico
Uma aplicação primária demonstra como esta infraestrutura catalisa a resiliência democrática e o florescimento comunitário. Organizações comunitárias focadas em engajamento cívico, sensemaking e participação democrática operam de forma dispersa por cidades e regiões, cada uma desenvolvendo práticas valiosas, mas incapazes de coordenar-se efetivamente. Os líderes ficam sobrecarregados tentando gerenciar seu próprio hub ao mesmo tempo em que constroem relacionamentos com pares.
Com esta infraestrutura de mapeamento, essas organizações se tornam visíveis como uma rede coordenada. Os coordenadores de hubs cívicos podem:
- Identificar lacunas onde novos hubs são necessários
- Conectar organizações com capacidades complementares para programas conjuntos
- Compartilhar estratégias bem-sucedidas adaptadas a contextos locais
- Rastrear o impacto no desenvolvimento de habilidades individuais, na construção de confiança comunitária e no fortalecimento institucional
- Demonstrar impacto coletivo a financiadores que apoiam a resiliência democrática
Esse modelo cria efeitos multiplicadores: à medida que as comunidades desenvolvem sensemaking e liderança cívica mais fortes, todas as outras iniciativas cívicas se tornam mais eficazes. Construímos a infraestrutura relacional e de desenvolvimento que fortalece todo o ecossistema.
Vale nomear uma pergunta anterior: vários mapas de ecossistema que cobrem organizações cívicas já existem, incluindo o NCL Healthy Democracy Ecosystem Map, o Catalist e o Hylo. As lacunas de coordenação descritas aqui persistiram apesar desses recursos. É mais provável que esta infraestrutura produza os efeitos descritos acima quando combinada com facilitação ativa — alguém cujo papel é agir sobre a visibilidade que os dados proporcionam, não apenas mantê-la.2
2.2 Otimizando o Ecossistema Regenerativo
Uma aplicação vital demonstra como esta infraestrutura transforma iniciativas regenerativas fragmentadas em movimentos biorregionais coordenados. Organizações regenerativas que trabalham com restauração do solo, manejo de bacias hidrográficas, soberania alimentar e renovação de ecossistemas operam isoladamente, apesar de lidarem com sistemas ecológicos e sociais interconectados. Podemos encontrar um coletivo de permacultura desenvolvendo práticas de agricultura regenerativa enquanto um conselho de bacia hidrográfica trabalha na restauração ripária, um hub alimentar constrói cadeias de suprimento locais, e um land trust protege habitat crítico. Todos eles poderiam operar dentro da mesma biorregião com consciência limitada de possíveis sinergias — embora, em muitos casos, a falha de coordenação tenha menos a ver com descoberta do que com competição por recursos, incompatibilidade de governança ou diferentes teorias de manejo da terra que a mera visibilidade não resolve.3
Com esta infraestrutura de mapeamento, essas iniciativas se tornam visíveis como um ecossistema regenerativo integrado. Os coordenadores podem:
- Mapear capacidades organizacionais em relação às necessidades biorregionais, revelando lacunas de cobertura
- Conectar agricultores regenerativos com land trusts que possuem propriedades adequadas
- Ligar projetos de restauração ecológica a instituições educacionais que precisam de sítios de campo
- Coordenar cadeias de suprimento conectando produtores regenerativos a distribuidores e consumidores alinhados com a missão
- Demonstrar impacto coletivo a financiadores que apoiam o desenvolvimento regenerativo e a resiliência climática
Isso cria coerência biorregional, à medida que os esforços de restauração se alinham com os limites das bacias hidrográficas, os fluxos econômicos apoiam a saúde ecológica, e o manejo da terra integra o conhecimento indígena com a ciência contemporânea. Construímos a infraestrutura de coordenação que permite que os sistemas regenerativos funcionem como redes vivas, e não como projetos isolados.
2.3 A Criação de Redes de Ação Global
Uma aplicação transformadora demonstra como esta infraestrutura possibilita o surgimento de redes de ação global (GANs) coordenadas para enfrentar desafios civilizacionais. Uma GAN reúne uma variedade de entidades e instituições dos setores governamental, sem fins lucrativos e privado para trabalhar de forma colaborativa no enfrentamento de questões críticas cujo impacto transcende a geografia.
Em todo o mundo, há pessoas trabalhando em iniciativas importantes que reconhecem a necessidade de respostas adequadas à escala e à interconexão das ameaças e crises globais, incluindo a ruptura climática, a erosão democrática, a transformação tecnológica e a sobrecarga de (des)informação. No entanto, os esforços para construir coordenação global fracassam repetidamente porque ou impõem estruturas de cima para baixo que ignoram os contextos locais, ou permanecem redes puramente aspiracionais sem infraestrutura operacional.
Organizações estabelecidas que buscam abordagens integrativas, incluindo os nascentes movimentos metamodernos, comunidades integrais, redes regenerativas e iniciativas de mudança de sistemas, operam em paralelo sem consciência suficiente de esforços complementares ou mecanismos para coordenação estratégica. Cada uma desenvolve soluções parciais dentro do seu próprio enquadramento de visão de mundo, incapaz de descobrir como suas perspectivas se integram com as de outras ou como a coordenação poderia criar impacto em escala civilizacional.
Podemos ver grandes instituições — o que incluiria universidades, ONGs internacionais, corporações com visão de futuro e agências governamentais inovadoras — reconhecendo que as abordagens convencionais estão fracassando. Apesar das evidências de fracasso do status quo, essas entidades carecem de frameworks para se engajar com os movimentos integrativos emergentes. Essas instituições possuem recursos substanciais, credibilidade estabelecida e capacidade de implementação, mas operam dentro de pressupostos de visão de mundo desatualizados. A infraestrutura de mapeamento cria uma ponte: as instituições podem descobrir e se engajar com iniciativas integrativas que demonstram alternativas viáveis, e os movimentos de base podem ter acesso a recursos institucionais e capacidade de escala. Isso possibilita uma transição crucial, na qual as instituições não apenas financiam alternativas, mas participam ativamente de redes coordenadas. Isso utiliza as imensas capacidades das instituições ao mesmo tempo em que evolui seus próprios pressupostos de visão de mundo, por meio de colaboração autêntica com as iniciativas emergentes e suas ideias de próxima geração.
Este caso de uso representa a cadeia causal mais longa do documento e deve ser entendido como uma aspiração de longo horizonte, e não como um resultado de curto prazo da infraestrutura. O framework GAN de Waddell, citado na Seção 5.6, documenta redes que emergiram de trabalho relacional sustentado ao longo de anos, e não de uma melhor descobribilidade de dados. A infraestrutura descrita aqui pode apoiar esse trabalho; não pode substituí-lo.4
2.4 Abordando Problemas e Crises Sistêmicas
Uma aplicação crítica demonstra como esta infraestrutura possibilita respostas coordenadas a desafios em escala civilizacional, conectando pontos de alavancagem a atores capazes de utilizá-los.
Organizações, fundações, agências governamentais e instituições de pesquisa reconhecem que a ruptura climática, a erosão democrática e a desigualdade econômica são desafios sistêmicos interconectados. No entanto, essas entidades tendem a operar dentro de um domínio específico, sem visibilidade clara de como seu trabalho se conecta às causas raiz ou de como a coordenação com outros domínios poderia ampliar seu impacto.
Com esta infraestrutura de mapeamento, esses atores descobrem seus pontos de alavancagem complementares. Para dar alguns exemplos: uma fundação que financia jornalismo comunitário se conectaria com pesquisadores que estudam estruturas de incentivo econômico e desenvolvedores de tecnologia que constroem alternativas prosociais. Uma organização ambiental liga seu trabalho de agricultura regenerativa a agências de desenvolvimento econômico, instituições educacionais que ensinam alfabetização ecológica, e organizações de políticas públicas que tratam de estruturas de propriedade que exigem extração.
A plataforma torna a análise de causa raiz acionável ao mostrar:
- Quais intervenções são enquadradas como abordando causas versus sintomas pelos atores e esquemas representados nos dados5
- Quais pontos de alavancagem cada organização controla
- Quem mais está trabalhando em desafios interconectados, onde a coordenação cria efeitos multiplicadores
Isso transforma o manejo isolado de sintomas em intervenção coordenada sobre causas raiz, demonstrando a financiadores e formuladores de políticas que desafios sistêmicos exigem — e podem alcançar — respostas sistêmicas.
Este caso de uso provavelmente se conectaria à Strategic Metacrisis Mapping Initiative, uma parceria entre o Institute of Applied Metatheory e o Eudaimonia Institute. Outra conexão possível seria com a pesquisa sobre metacrise conduzida pelo CRI.
2.5 Transparência de Financiadores e Medição de Impacto Multidimensional
Uma aplicação crítica de capacitação demonstra como esta infraestrutura aborda uma das falhas mais persistentes no investimento filantrópico e de impacto: a incapacidade de verificar se os recursos estão produzindo mudanças significativas e multidimensionais, e de comunicar isso claramente às pessoas que os fornecem.
Indivíduos e financiadores institucionais que consideram apoiar projetos dentro da web liminal, do ecossistema regenerativo e do espaço mais amplo de resposta à metacrise enfrentam um problema fundamental: pede-se a eles que financiem iniciativas majoritariamente não institucionais e baseadas em rede, cujo impacto é difuso, relacional e resistente à medição convencional de métrica única. Os financiadores muitas vezes não conseguem ver como suas contribuições se conectam a resultados, quem mais está financiando trabalho complementar, ou se a rede como um todo está avançando em uma direção coerente. Essa opacidade é uma barreira significativa para mobilizar o capital de que essas iniciativas precisam.
Com esta infraestrutura de mapeamento, os financiadores ganham uma visão multidimensional e em tempo real do ecossistema que estão apoiando. Isso inclui:
- Visibilidade do portfólio — todas as entidades financiadas apresentadas em uma única visão, com suas relações entre si e com os objetivos mais amplos da rede
- Rastreabilidade de contribuição — um registro claro e auditável de para onde o financiamento flui e quais atividades apoia
- Impacto relacional — como as organizações financiadas estão conectadas e catalisando atividade em partes adjacentes da rede, revelando efeitos multiplicadores que os relatórios de uma única organização não captam
- Indicadores multidimensionais — progresso rastreado simultaneamente nas dimensões de desenvolvimento, ecológica, cívica e social, sem ser reduzido a uma única métrica
- Contexto comparativo — como as iniciativas financiadas se comparam a esforços semelhantes em termos de alcance, profundidade e centralidade na rede
- Rastreamento longitudinal — como o ecossistema está mudando ao longo do tempo como resultado do investimento coordenado
Entregar essa capacidade exige estender o modelo de dados e o pipeline de formas específicas:
- Registro de eventos de impacto — um log estruturado de atividades, produtos e resultados associados a cada entidade, vinculado aos registros dessas entidades no grafo
- Esquema de indicadores multidimensionais — um framework para categorizar o impacto em dimensões (por exemplo, desenvolvimento individual, confiança comunitária, restauração ecológica, mudança institucional). Vários esquemas de categorização do diretório são relevantes aqui, incluindo a taxonomia da ecologia de resposta à metacrise do IAM e o esquema NCL Healthy Democracy.
- Modelo de relação financiador-entidade — representação explícita das relações de financiamento no grafo, incluindo valores, prazos e finalidades, com controles de privacidade apropriados
- Funções de agregação — a capacidade de consolidar dados de impacto de entidades individuais para os níveis de portfólio, rede e ecossistema
- Camada narrativa — espaço estruturado para contexto qualitativo ao lado de indicadores quantitativos, já que boa parte do que importa neste ecossistema resiste à redução a números
Para mais informações, ver o documento complementar Guia de Financiamento entre Pares e Finanças para os Bens Comuns.
2.6 Identidade Digital, Prova de Humanidade e Contribuição Responsável
Uma camada fundamental de capacitação apoia todos os outros casos de uso ao resolver um problema que se torna cada vez mais agudo à medida que a infraestrutura cresce: saber que as pessoas e organizações representadas no grafo são quem afirmam ser, e que as contribuições — de financiamento, conhecimento, trabalho e participação em governança — estão genuinamente ligadas a seres humanos reais e distintos, e não a bots, contas duplicadas ou atores pseudônimos que não podem ser responsabilizados. Uma consideração arquitetônica importante é como esta infraestrutura de mapeamento se integraria a sistemas de identidade digital, incluindo prova de humanidade. Isso é particularmente relevante quando a infraestrutura é usada para a responsabilização de financiadores (Seção 2.5), governança participativa, correspondência de necessidades/ofertas, e qualquer contexto em que confiança e verificabilidade importem.
A infraestrutura de rede aberta do tipo descrito neste documento historicamente tem enfrentado dificuldades com identidade de duas formas opostas: ou coleta dados pessoais demais, criando riscos de privacidade e vigilância, ou coleta de menos, possibilitando ataques Sybil, deturpação e a erosão da confiança. Um terceiro caminho — identidade digital verificável e que preserva a privacidade — tornou-se tecnicamente viável por meio da convergência de padrões de identificador descentralizado (DID), credenciais verificáveis (VCs) e sistemas de prova de conhecimento zero.
3. Análise de Fontes de Dados
A análise a seguir organiza os mais de 60 itens do diretório em categorias e avalia cada fonte de dados quanto à sua utilidade, método de acesso e relevância para os casos de uso centrais acima. Itens que são puramente diretórios de outros mapas, ou que são principalmente ilustrativos em vez de ricos em dados, são anotados, mas despriorizados. Observe que o diretório contém informações adicionais e links para os respectivos sites de cada um.
3.1 Nível 1 — Fontes de Dados de Alto Valor
Essas fontes contêm dados estruturados ou semiestruturados substanciais, diretamente relevantes para um ou mais casos de uso centrais. Devem ser priorizadas para integração antecipada.
| Fonte | Produtor | Tipos de Entidade | Método de Acesso |
|---|---|---|---|
| Second Renaissance Ecosystem Map | Life Itself | Pessoas, Organizações, Projetos, Mídia | API do Airtable ou exportação CSV (plataforma subjacente); JSON embutido do Cohere |
| Meta-Crisis Meta-Resource | Sloww | Pessoas, Organizações, Projetos, Mídia | Scraping de HTML estático (cofre publicado no Obsidian, estrutura consistente) |
| Healthy Democracy Ecosystem Map | National Civic League | Organizações, entidades políticas, baseadas em território | Scraping da web + contato de parceria; a NCL publica relatórios estruturados |
| P2P Foundation Wiki | Michel Bauwens | Pessoas, Organizações, Projetos, Tecnologia, Conceitual | API do MediaWiki (endpoint api.php, licenciamento aberto) |
| Hylo | Terran Collective | Pessoas, Organizações, Projetos, baseados em território | API GraphQL (código aberto, documentada) |
| Weavers Social Trust Map | Weavers | Pessoas, Projetos, baseados em território, Políticos | Exportação JSON do Kumu (URL de embed pública) |
| Big Map to Save the Future | Jon Schull | Pessoas, Organizações, Projetos, baseados em território | Scraping da web + possível parceria direta de dados |
| Conscious Change Collective | The Garrison Institute e Circles for Conscious Change | Organizações, Visões de mundo | Exportação JSON do Kumu (URL de embed pública) |
| Catalist | Catalist | Pessoas, Organizações, Projetos, Frameworks | API da plataforma (necessário contato com parceiro) |
| Civic Tech Guide | Civic Hall | Pessoas, Projetos, Tecnologia, Entidades políticas | Scraping de HTML estruturado |
3.2 Nível 2 — Fontes Especializadas ou Específicas de Domínio
Essas fontes são valiosas para camadas ou casos de uso específicos, mas não são amplas o suficiente ou acessíveis o suficiente para serem integrações de primeira prioridade.
| Fonte | Produtor | Domínio | Método de Acesso |
|---|---|---|---|
| Restor | Restor | Projetos baseados em território, biorregiões | API pública (documentada) |
| One Earth Bioregion Map | One Earth | Baseado em território, biorregiões | Camadas de dados Mapbox (públicas) |
| Planetary Portal | Berggruen Institute | Organizações (governança global) | Scraping da web |
| NooNAO | Brad de Graf | Pessoas, Organizações, Projetos, Biorregiões | Parceria (conexão com o grupo de trabalho World Wise Web) |
| Thaumazo Community Mycelium | Daniel Lindenberger | Pessoas, Organizações, Projetos, Biorregiões | Contato de parceria |
| Web3 Meta-Crisis Wiki | Benjamin Life | Tecnologias | Scraping de HTML estático (GitHub Pages) |
| Decentralized Tech Ecosystem Map | Christina Bowen | Tecnologias | Exportação JSON do Kumu |
| ReFi Ecosystem | ReFi DAO | Pessoas, Organizações, Projetos | Scraping da web / possível API |
| Gaianet Ecosystem | Gaianet | Pessoas, Organizações, Projetos, Tecnologia, Mídia | Scraping da web |
| SuperConnector | MIT | Pessoas, Projetos | API (com capacidade de automação, segundo o diretório) |
| Global Ecovillage Map | Kosha Joubert | Pessoas, Organizações, baseadas em território | Scraping da web (plataforma de mapa da GEN) |
| Standingwave Bioregional | NooNAO / Standingwave | Baseado em território, biorregiões | Embed do Mapbox + parceria |
| ICmatch | Ardell Broadbent | Conexão de cofundadores de comunidades intencionais para projetos baseados em território | Contato de parceria e marketing no Facebook para grupos de comunidades intencionais |
3.3 Esquemas de Categorização
Esses itens não contribuem com dados de entidade, mas fornecem frameworks taxonômicos que podem ser aplicados para classificar entidades existentes. São usados na camada de Enriquecimento do pipeline.
| Esquema | Produtor | O Que Classifica | Aplicação |
|---|---|---|---|
| The Social Change Map | Deepa Iyer | Organizações, pessoas (por papel no movimento) | Aplicar a todas as entidades de organização/pessoa — atribuir papéis: construtor, disruptor, curador, tecelão etc. |
| Mapping an Ecology of Integrative Approaches | Nørgaard, Hedlund, Meglin (IAM) | Organizações, projetos (por abordagem integrativa) | Aplicar a entidades orientadas à web liminal e à metacrise — fornece categorização refinada e alinhada ao ecossistema do IAM |
| Wisdom Age | Roote | Visões de mundo | Marcar entidades por afiliação ou orientação de visão de mundo |
| Esquema do Healthy Democracy Ecosystem Map | National Civic League | Organizações cívicas | Classificar organizações cívicas na taxonomia de democracia saudável da NCL |
| Esquema do Planetary Portal | Berggruen Institute | Organizações de governança global | Classificar organizações que operam em escala global/institucional |
| Context (IAM) | Institute of Applied Metatheory | Estruturas conceituais e interconexões | Aplicar a taxonomia de frameworks do IAM a entidades conceituais; potencial para classificação assistida por IA |
| Connectioning | J. Friday | Organizações / atores de rede | Esquema de categorização com suporte a automação — avaliar para uso na tipificação de relações |
| Conscious Change Collective | The Garrison Institute e Circles for Conscious Change | Questões sociais, tipos de comunidades atendidas, modalidades de trabalho interior, religiões, papel organizacional | Oferecer conexões entre organizações que fazem trabalho de mudança consciente e organizações que fazem trabalho complementar em outros domínios, como agricultura regenerativa, desenvolvimento de infraestrutura, organização comunitária etc. |
3.4 Fontes Nativas de Protocolo
O Murmurations merece um tratamento separado das fontes acima. Não é apenas uma fonte de dados, mas um protocolo — um padrão pelo qual organizações autopublicam perfis estruturados em URLs previsíveis, e um índice de rede que coleta esses perfis. Isso significa que:
- Como fonte de ingestão, o Murmurations fornece um feed continuamente atualizado de dados de perfil de organizações que se autopublicaram — sem necessidade de scraping.
- Como mecanismo de publicação, aplicativos e plataformas podem publicar perfis do Murmurations, tornando-os descobríveis por toda a rede.
- A API de índice do Murmurations permite consultas filtradas por campo, localização, tipo de relação e esquema.
Essa bidirecionalidade — ingerir de e publicar no mesmo protocolo — torna o Murmurations excepcionalmente valioso para uma infraestrutura federada. Deveria ser uma das primeiras integrações implementadas.
3.5 Fontes a Despriorizar
Os seguintes itens do diretório são diretórios de outros mapas (já contabilizados), são principalmente ilustrativos/educacionais, ou são difíceis demais para extrair dados estruturados neste estágio:
- An Overview of Second Renaissance Ecosystem Mapping Efforts (Life Itself) — diretório de diretórios; útil para descoberta, mas não uma fonte de ingestão
- The Flourishing of All Living Things (Naryan Wong) — diretório de mapas
- Grassroots Network of Networks (Michael Haupt) — baseado em Roam; extração estruturada difícil sem cooperação do proprietário
- Jerry’s Brain (Jerry Michalski) — rico, mas idiossincrático; alto custo de curadoria por entidade
- Wisdom Wayfarer (Patrick Barry) — Google Sites; principalmente ilustrativo
- Joe Lightfoot’s Liminal Web Map — post de blog com imagem incorporada; baixo valor estrutural como fonte de dados
- Memetic Tribes of Culture War 2.0 — Planilha do Google com dados de visão de mundo; útil como referência, mas de escopo limitado
- Mapping the Noosphere (Human Energy) — principalmente visualização, dados estruturados limitados
- Encyclopedia of Big Pictures (IAM/ARC) — em desenvolvimento; integrar quando disponível
4. Análise de Ferramentas de Automação
O diretório inclui vários itens com capacidades de automação. A análise a seguir avalia cada um quanto ao seu papel no pipeline da infraestrutura, seu perfil de custo e sua prioridade de implementação.
4.1 Orquestração de Pipeline
n8n
O n8n é uma plataforma de automação de fluxo de trabalho de código aberto, com um editor visual de nós, suporte a requisições HTTP, webhooks, agendamentos e lógica condicional. É a espinha dorsal recomendada para as camadas de ingestão e normalização deste pipeline.
- Casos de uso: agendar extrações de dados de APIs e scrapers; disparar tarefas de normalização e deduplicação; rotear fluxos de enriquecimento; enviar alertas quando novas entidades são detectadas; coordenar execuções em lote de classificação
- Custo: gratuito quando autoalojado; plano em nuvem disponível para implantação gerenciada
- Prioridade: Alta — implementar primeiro
Alternativa: o Make (antigo Integromat) oferece funcionalidade semelhante com uma interface mais polida, mas um modelo pago. Pode ser preferível para equipes menos confortáveis com autoalojamento. Uma segunda alternativa é o Apache Airflow, mais poderoso para pipelines complexos baseados em DAG, mas que exige mais sobrecarga de DevOps.
4.2 Embeddings e Inteligência Semântica
Nomic Atlas
O Nomic Atlas é uma plataforma para construir mapas navegáveis de grandes conjuntos de dados usando embeddings. Ele aceita registros estruturados, calcula embeddings vetoriais e possibilita agrupamento semântico e busca por similaridade. É a ferramenta recomendada para os componentes de inferência de relações e detecção de sincronicidade da camada de Enriquecimento.
- Casos de uso: incorporar descrições de entidades para possibilitar busca por similaridade semântica; agrupar entidades em vizinhanças temáticas; revelar afinidades ocultas entre entidades que não estão explicitamente ligadas
- Custo: nível gratuito disponível para conjuntos de dados pequenos a médios; pago para coleções maiores
- Prioridade: Alta para recursos de descoberta de adjacência regenerativa e de engajamento cívico; média para a OpenHaven
Alternativas: um banco de dados vetorial autoalojado (Qdrant, Chroma ou pgvector) combinado com um modelo de embedding de código aberto (por exemplo, sentence-transformers) oferece a mesma capacidade a um custo menor e com mais controle. Este é o caminho recomendado se a privacidade dos dados for uma preocupação ou se o conjunto de dados crescer muito.
4.3 Visualização e Percurso de Grafos
Kumu
O Kumu é uma ferramenta de mapeamento de relações usada por várias fontes do diretório. Já está incorporado ao ecossistema e suporta importação/exportação JSON, o que o torna útil tanto como fonte de ingestão (extraindo dados de mapas baseados em Kumu) quanto como camada de visualização (renderizando o grafo para exploração humana).
- Casos de uso: publicar visualizações navegáveis por humanos do grafo de entidades; aceitar exportações JSON de mapas parceiros; fornecer uma interface acessível para membros da comunidade não técnicos
- Custo: gratuito para projetos públicos; pago para mapas privados
- Prioridade: Média — útil como front-end de visualização, mas não obrigatório para o pipeline central
HuViz
O HuViz é uma ferramenta de visualização de grafos RDF de código aberto. Se a camada de armazenamento expõe um endpoint SPARQL, o HuViz pode servir como uma interface de percurso pública e sem custo para o grafo de interconexões conceituais.
- Casos de uso: exploração pública das relações de estruturas conceituais; visualização de dados vinculados/RDF
- Custo: gratuito (código aberto)
- Prioridade: Baixa-média — relevante se RDF/SPARQL for adotado para a camada conceitual
4.4 Inteligência Geográfica e Territorial
ArcGIS
O ArcGIS fornece camadas de dados geoespaciais, APIs de mapeamento e ferramentas de análise. É relevante para as camadas de biorregião e projetos baseados em território do modelo de dados.
- Casos de uso: dados de polígonos de biorregião; enriquecimento geográfico de entidades baseadas em território; visualização de território
- Custo: o ArcGIS Online tem um nível gratuito com acesso a dados públicos; a plataforma completa é cara. Considere usar alternativas gratuitas (QGIS, OpenStreetMap, camadas de dados da One Earth) para a funcionalidade central
- Prioridade: Média para casos de uso de território/biorregião; avaliar a cobertura do nível gratuito antes de se comprometer
Whole Earth Codec / Planet Labs
Essas ferramentas fornecem imagens de satélite e análises da Terra. São relevantes para os casos de uso mais avançados de monitoramento territorial, mas provavelmente estão fora do escopo no curto prazo, dado o custo e a complexidade.
- Prioridade: Baixa — adiar até que os casos de uso baseados em território estejam mais desenvolvidos
4.5 Grafo de Conhecimento e Mapeamento Conceitual
Obsidian e Roam
Ambas as ferramentas aparecem no diretório como ambientes de grafo de conhecimento com capacidade de automação. No contexto desta infraestrutura, são mais úteis como ferramentas de autoria voltadas para os contribuidores — membros da equipe e contribuidores da comunidade podem manter notas estruturadas no Obsidian ou no Roam, que são periodicamente exportadas e ingeridas no grafo principal. O plugin Dataview do Obsidian, em particular, possibilita consultas estruturadas em cofres locais que podem ser exportadas como JSON.
- Casos de uso: gestão de conhecimento dos contribuidores; fonte de exportação estruturada para trabalho de curadoria manual
- Custo: o Obsidian é gratuito (local); o Roam tem assinatura. Ambos têm plugins comunitários para exportação
- Prioridade: Baixa para o pipeline; média para o fluxo de trabalho dos contribuidores
IAM Context
O Context (contextdriven.ai) é uma plataforma produzida pelo IAM para mapeamento e interconexão de estruturas conceituais. Tem tanto capacidades de fonte de dados quanto de automação. Dada a relação com o IAM, é uma candidata natural para integração — tanto trazendo seus dados de estrutura conceitual para o grafo quanto potencialmente usando suas capacidades de categorização para classificar outras entidades.
- Casos de uso: ingestão de dados de estruturas conceituais; categorização assistida por IA de frameworks e ideias
- Custo: avaliar por meio de parceria com o IAM
- Prioridade: Média — coordenar com o IAM os termos de integração
4.6 Ferramentas de Automação a Despriorizar
O Omni Mapping Project (Buckminster Fuller Institute) e o PLAN Systems têm capacidades de automação listadas, mas suas APIs específicas e caminhos de integração não estão bem documentados em fontes públicas. Devem ser monitorados, mas não priorizados para implementação antecipada.
5. Arquitetura do Pipeline
A arquitetura está organizada em cinco camadas. Cada camada tem um conjunto definido de entradas, transformações e saídas. As camadas são projetadas para serem implementadas de forma incremental — um pipeline mínimo viável pode ser construído com as três primeiras camadas e expandido a partir daí.
5.1 Camada 1 — Ingestão
A camada de Ingestão é responsável por extrair dados de fontes externas de forma agendada ou acionada, e depositá-los em uma área de staging bruta. Não transforma nem valida dados — sua única função é a recuperação confiável.
Fluxos de entrada
- APIs nativas de protocolo: índice do Murmurations, GraphQL do Hylo, API MediaWiki da P2P Foundation, API do Restor, API do SuperConnector
- Scrapers de web agendados: metacrisis.org (HTML do Obsidian), Civic Tech Guide, páginas públicas do Catalist, Second Renaissance / Cohere (se o acesso direto ao Airtable não estiver disponível), Planetary Portal, ReFi Ecosystem, Web3 Metacrisis Wiki
- Exportações JSON do Kumu: Weavers Social Trust Map, mapa do ecossistema Decentralized Tech, mapa Limicon, e quaisquer outros mapas públicos baseados em Kumu
- Importações manuais/em lote: exportações CSV de mapas baseados em Airtable, envios de dados de parceiros, exportações de cofres do Obsidian/Roam de contribuidores
- APIs geo/satélite: camadas públicas do ArcGIS, dados Mapbox da One Earth, dados de biorregião do Standingwave, dados de projetos baseados em território do Restor
Opções de ferramentas
- Opção A (recomendada): n8n autoalojado como motor de orquestração. Os nós do n8n lidam com requisições HTTP, análise de JSON, disparo agendado e escrita no banco de dados de staging. Isso exige um servidor Linux (2+ GB de RAM) com Docker.
- Opção B: Make (hospedado em nuvem, sem autoalojamento). Menor sobrecarga operacional, mas tem custos por operação que aumentam com a escala. Melhor para equipes sem capacidade de DevOps.
- Opção C: scripts Python personalizados gerenciados por cron ou um agendador em nuvem (GitHub Actions, Fly.io, Railway). Máxima flexibilidade, mas exige tempo de engenharia para manutenção.
Armazenamento de staging
Os dados brutos devem chegar a uma área de staging relacional simples antes da normalização. Um banco de dados Postgres com uma tabela por tipo de fonte funciona bem. Isso fornece um ponto de verificação — se a normalização falhar, os dados brutos são preservados e o processo pode ser reexecutado sem uma nova busca.
5.2 Camada 2 — Normalização
A camada de Normalização transforma dados brutos heterogêneos em um modelo de entidade unificado. É a camada intelectualmente mais exigente para projetar bem — as decisões tomadas aqui determinam quais tipos de consultas e relações são possíveis mais adiante.
Modelo de entidade unificado
Os tipos de entidade recomendados são:
- Pessoa — indivíduos com atributos: nome, papéis, afiliações, localização geográfica, informações de contato, links de perfil
- Organização — entidades legais com atributos: nome, tipo (sem fins lucrativos, cooperativa, empresa, grupo informal), setor, escopo geográfico, site
- Projeto / Iniciativa — esforços delimitados com atributos: status, datas de início/término, organização(ões)-mãe, stack tecnológico, foco temático
- Tecnologia — protocolos, plataformas e ferramentas com atributos: maturidade, licença, modelo de governança, capacidades, ecossistema
- Estrutura Conceitual — frameworks teóricos publicados com atributos: domínio, citações-chave, pensadores associados, escopo de aplicação
- Lugar — entidades geográficas com atributos: tipo (biorregião, cidade, país, território), coordenadas, polígono, hierarquia administrativa
- Mídia — artefatos de conteúdo com atributos: tipo (livro, podcast, vídeo, blog), criador(es), data de publicação, URL
Deduplicação
O problema mais difícil na normalização é a resolução de entidades — reconhecer que “Life Itself” em uma fonte e “Life-Itself” em outra se referem à mesma organização. Recomenda-se uma abordagem em duas passagens:
- Correspondência aproximada de strings (fuzzy matching): usar uma biblioteca como o RapidFuzz (Python) para encontrar candidatos a duplicata acima de um limiar de similaridade (por exemplo, 0,85). Sinalizar esses casos para revisão.
- Similaridade de embedding: incorporar o nome + descrição da entidade e calcular a similaridade de cosseno. Entidades textualmente semelhantes, mas com nomes diferentes, aparecerão aqui.
- Fila de revisão humana: casos limítrofes (similaridade entre 0,7 e 0,9) entram em uma interface leve de revisão, onde um curador confirma ou rejeita a fusão.
- Registro canônico: duplicatas confirmadas são fundidas em um registro canônico com rastreamento de proveniência — os registros de origem são preservados e vinculados ao canônico.
Opções de ferramentas
- Opção A: scripts de normalização baseados em Python, disparados pelo n8n, escrevendo no Postgres. Usa o RapidFuzz para correspondência aproximada e sentence-transformers para deduplicação baseada em embedding.
- Opção B: um serviço comercial de resolução de entidades (por exemplo, Senzing, que tem uma edição comunitária gratuita), se o problema de resolução de entidades se mostrar complexo em escala.
- Opção C: resolução assistida por LLM para casos ambíguos — um prompt estruturado que apresenta dois registros candidatos e pergunta se são a mesma entidade. Isso é caro em escala, mas eficaz para os casos difíceis.
5.3 Camada 3 — Enriquecimento
A camada de Enriquecimento adiciona atributos derivados às entidades normalizadas: tags de categoria a partir de esquemas aplicados, tipos de relação inferidos, enriquecimento geográfico e embeddings semânticos.
Categorização
Cada esquema de categorização do diretório pode ser aplicado como uma tarefa de marcação em lote. O processo para cada esquema é:
- Definir as categorias do esquema e suas descrições em um prompt estruturado.
- Para cada entidade do tipo relevante (por exemplo, todas as organizações), enviar uma solicitação de classificação a um LLM com o nome, a descrição da entidade e as opções de categoria do esquema.
- Armazenar a(s) tag(s) resultante(s) como atributos de aresta no grafo, preservando qual esquema produziu qual tag.
Esquemas recomendados para implementação antecipada: Social Change Map (papéis), taxonomia de Ecologia do IAM (abordagens integrativas), taxonomia NCL Healthy Democracy (organizações cívicas), Planetary Portal (organizações de governança global).
Inferência de relações
Além das relações explícitas declaradas nos dados de origem, o grafo pode se beneficiar de relações inferidas:
- Coafiliação: duas pessoas que são afiliadas à mesma organização têm uma relação implícita que vale a pena revelar
- Proximidade temática: entidades cujas descrições se agrupam no espaço de embedding provavelmente estão relacionadas, mesmo que nenhuma conexão explícita esteja documentada
- Colocalização geográfica: entidades que operam na mesma biorregião ou cidade têm proximidade contextualmente significativa
- Afinidade baseada em esquema: entidades que compartilham várias tags de categoria em vários esquemas têm um posicionamento convergente que vale a pena tornar explícito
Geração de embeddings
Todos os registros de entidade devem ser incorporados após a normalização e o enriquecimento. O vetor de embedding possibilita busca semântica e agrupamento.
- Opção A: Nomic Atlas — enviar registros e calcular embeddings por meio do serviço gerenciado deles; a visualização do atlas é um subproduto
- Opção B: sentence-transformers (local, gratuito) — executar a geração de embeddings na própria infraestrutura usando modelos como all-MiniLM-L6-v2 ou uma variante ajustada ao domínio
Enriquecimento geográfico
Para entidades com dados de localização, anexar informações de biorregião, bacia hidrográfica e limite administrativo. Isso possibilita filtragem geográfica e recomendações sensíveis ao território.
- Usar o esquema de biorregião da One Earth como a taxonomia de biorregião primária
- Geocodificar endereços em coordenadas usando o OpenStreetMap Nominatim (gratuito) ou a API do Google Maps
- Realizar buscas ponto-em-polígono para atribuir associações de biorregião e entidade política
5.4 Camada 4 — Armazenamento
A camada de Armazenamento persiste os dados normalizados e enriquecidos em dois sistemas complementares: um banco de dados de grafo para dados explícitos de relação entre entidades, e um armazenamento vetorial para busca semântica.
Banco de dados de grafo
Um banco de dados de grafo é a opção natural para esse modelo de dados, porque o valor principal do conjunto de dados está nas relações entre entidades, não nas entidades isoladamente.
- Opção A (recomendada para a maioria das equipes): Neo4j Community Edition — madura, bem documentada, gratuita para implantação autoalojada de servidor único. Linguagem de consulta Cypher robusta, boas ferramentas de visualização, amplos recursos comunitários.
- Opção B: SurrealDB — mais nova, modelo de esquema mais flexível (suporta grafo + documento + relacional em um só), API mais moderna, mas ecossistema menos maduro. Boa escolha se você quiser minimizar a complexidade da infraestrutura.
- Opção C: Apache AGE (Age Graph Extension para Postgres) — adiciona capacidades de grafo ao Postgres, permitindo manter uma única tecnologia de banco de dados. Melhor se você já estiver comprometido com o Postgres para o armazenamento de staging.
- Opção D: perspectivas do AD4M — se a infraestrutura for construída de forma centrada no agente, em vez de centrada no servidor, as perspectivas do AD4M fornecem um grafo soberano e nativo em RDF, no qual cada agente mantém seus próprios dados e compartilha por meio de “neighbourhoods”. Isso elimina completamente o banco de dados de grafo central em favor de um modelo federado. Isso é arquitetonicamente mais ambicioso e se afasta do pipeline hospedado em servidor descrito neste documento, mas pode ser a direção certa no longo prazo, dados os valores do ecossistema e o trabalho de desenvolvimento ativo na Coasys.
Armazenamento vetorial
O armazenamento vetorial mantém vetores de embedding para busca semântica. Ele opera como um complemento ao banco de dados de grafo, e não como um substituto.
- Opção A (recomendada para autoalojamento): Qdrant — projetado especificamente para busca vetorial, bem documentado, gratuito e de código aberto, implantável via Docker, suporta filtragem de payload
- Opção B: pgvector — extensão do Postgres; a mais simples se você já estiver rodando Postgres
- Opção C: Chroma — leve, fácil de começar, bom para desenvolvimento; menos testado em escala
- Opção D: Pinecone — totalmente gerenciado, excelente desempenho, mas com custos contínuos por consulta
5.5 Camada 5 — Serviço
A camada de Serviço expõe os dados armazenados por meio de um conjunto de funções que podem ser consumidas por qualquer número de aplicações front-end ou serviços a jusante. A camada de serviço é deliberadamente definida em termos de funções, e não de plataformas específicas, para que a mesma infraestrutura possa alimentar várias interfaces front-end simultaneamente.
Descoberta e busca de entidades
A função de serviço mais fundamental: dada uma consulta (palavra-chave, descrição semântica ou filtro de tipo de entidade), retornar entidades correspondentes com seus atributos e relações. Essa função é a base de qualquer diretório, interface de busca ou recurso de recomendação.
- Implementação: API GraphQL ou REST envolvendo consultas ao banco de dados de grafo, com busca semântica como sinal de classificação secundário a partir do armazenamento vetorial
Percurso de relações
Dada uma entidade de partida, retornar seus vizinhos até N graus de separação, opcionalmente filtrados por tipo de relação, tipo de entidade ou atributo. Essa função é a base da visualização de rede, da descoberta de adjacências e do caso de uso “encontrar pessoas/organizações próximas a este conceito”.
- Implementação: consultas de percurso de banco de dados de grafo (Cypher para o Neo4j); parametrizadas por profundidade, direção e predicados de filtro
Categorização e marcação
Dada uma entidade ou um conjunto de entidades, retornar suas tags de categoria em um ou mais esquemas aplicados. Possibilita filtragem por papel, abordagem, foco temático ou escopo geográfico.
- Implementação: busca de atributo no banco de dados de grafo; resultados de tarefas de classificação armazenados como atributos de aresta da entidade até o nó de categoria
Similaridade semântica
Dada uma entidade ou uma descrição em texto livre, retornar as entidades mais semanticamente semelhantes no grafo. Esta é a função central para descoberta de adjacência, correspondência de necessidades/ofertas e detecção de sincronicidade.
- Implementação: consulta de vizinho mais próximo no armazenamento vetorial, usando o embedding da entidade ou texto de consulta; resultados combinados com dados do grafo para uma resposta enriquecida
Consulta geográfica
Dada uma localização, raio ou identificador de biorregião, retornar entidades presentes ou operando naquela área. Possibilita visões territoriais, painéis de biorregião e coordenação localmente relevante.
- Implementação: consulta geoespacial combinando buscas ponto-em-polígono com percurso de grafo
Feed de mudanças e alertas
Emitir eventos quando novas entidades são ingeridas, quando entidades existentes são atualizadas, ou quando novas relações são inferidas. Possibilita recursos de coordenação em tempo real e sistemas de notificação.
- Implementação: captura de dados de mudança (CDC) no banco de dados com entrega via webhook; o n8n pode servir como roteador de eventos
Exportação e federação
Permitir que organizações parceiras extraiam dados de entidade em formatos padrão (JSON de perfil Murmurations, CSV, JSON-LD). Possibilita que os dados voltem a fluir para o ecossistema mais amplo, contribuindo para os bens comuns em vez de apenas consumir deles.
- Implementação: endpoints de exportação parametrizados; gerador de perfil Murmurations para qualquer tipo de entidade
O modelo de “neighbourhood” do AD4M — em que perspectivas compartilhadas são sincronizadas ponto a ponto por meio de “link languages” plugáveis, em vez de enviadas a um endpoint central — representa uma implementação mais nativa dessa função do que um índice ao estilo Murmurations, e vale a pena avaliar à medida que a arquitetura de federação amadurece.
5.6 Metodologia Analítica: Mapping for Clarity e o Framework GRASP
As cinco camadas técnicas descritas acima (Ingerir, Normalizar, Enriquecer, Armazenar, Servir) definem como os dados se movem pela infraestrutura. Esta seção aborda uma questão complementar: uma vez que os dados estejam fluindo e as funções de serviço estejam operacionais, como os praticantes devem de fato usar essa infraestrutura para produzir percepção e ação significativas para as redes e comunidades que ela pretende apoiar?
A resposta proposta aqui se baseia no framework Mapping for Clarity (MfC), desenvolvido por Jim Ritchie-Dunham e descrito em Global Action Networks (2011), de Steve Waddell. O MfC é uma metodologia baseada em sistemas para tornar redes complexas legíveis — não apenas de forma descritiva, mas estratégica, conectando aquilo com que os participantes se importam aos pontos de alavancagem onde a intervenção teria mais efeito. Seu conceito analítico central é o GRASP:
- Goal (Objetivo) — Por que a rede existe?
- Resources (Recursos) — Quais recursos geram valor para as partes interessadas, e quais possibilitam o trabalho que cria esse valor?
- Actions (Ações) — Quais ações alavancam mais efetivamente os recursos capacitadores?
- Structure (Estrutura) — Quais são as ligações entre os objetivos, recursos e ações?
- People (Pessoas) — Com o que as pessoas se importam neste sistema?
Essas cinco perguntas fornecem uma lente estruturada para analisar qualquer rede cujas entidades tenham sido ingeridas e mapeadas. Em vez de tratar os dados como um diretório estático, o GRASP os trata como um sistema dinâmico que pode ser interrogado para revelar desalinhamentos, lacunas e pontos de alavancagem.
Aplicando o GRASP à infraestrutura
Para cada rede, ecossistema ou caso de uso revelado pela infraestrutura, os praticantes podem percorrer os elementos do GRASP usando os dados e ferramentas já presentes no pipeline:
Objetivo (Goal): Os esquemas de categorização aplicados na camada de Enriquecimento (taxonomia da ecologia de metacrise do IAM, Social Change Map, esquema NCL Healthy Democracy) codificam, cada um, uma teoria implícita do que as redes em seu domínio estão tentando alcançar. Comparar o objetivo declarado de uma rede (a partir dos dados de seu próprio perfil) com os objetivos implícitos em sua categorização pode revelar divergências — organizações que acreditam estar fazendo um tipo de trabalho, mas cujas relações e atividades se agrupam em torno de outro.
Recursos (Resources): O grafo de entidades contém tanto os recursos geradores de valor (o que as partes interessadas precisam da rede para permanecerem engajadas e participando) quanto os recursos capacitadores (o que torna o trabalho possível). As funções de percurso de relações podem identificar quais entidades fornecem recursos capacitadores críticos — infraestrutura, financiamento, conhecimento, capacidade de convocação — e quais estão mal atendidas em seu acesso a esses recursos. Essa é a base para a correspondência de necessidades/ofertas.
Ações (Actions): A função de similaridade semântica, combinada com o registro de eventos de impacto descrito na Seção 2.5, pode identificar quais tipos de ações estão mais fortemente correlacionados com resultados de impacto entre redes comparáveis. Com o tempo, à medida que mais redes registram dados de atividade, a infraestrutura acumula evidências comparativas sobre quais ações, em quais posições de rede, tendem a produzir efeitos multiplicadores.
Estrutura (Structure): A função de percurso de relações mapeia diretamente questões estruturais: quem está conectado a quem, a que grau de separação, por quais nós intermediários? A análise de Waddell sobre a rede sul-africana da Global Reporting Initiative ilustra como a análise estrutural revela organizações-ponte, clusters isolados e grupos de partes interessadas pouco conectados. A mesma análise está disponível aqui para qualquer rede no grafo, usando medidas padrão de centralidade de grafo (intermediação, proximidade, grau), aplicadas por meio de consultas no Neo4j ou no SurrealDB.
Pessoas (People): Este é o elemento mais qualitativo e o mais difícil de automatizar. A camada narrativa do modelo de dados de impacto — onde as entidades podem anexar contexto qualitativo estruturado a seus registros de atividade — é onde reside “aquilo com que as pessoas se importam”. O agrupamento baseado em embedding no Nomic Atlas pode revelar proximidade temática entre o que diferentes atores expressam como suas motivações e valores, mesmo quando usam linguagens diferentes para descrevê-los.
Usando o GRASP para orientar prioridades de automação
Nem todo trabalho de automação tem o mesmo valor. O GRASP fornece um framework de decisão para priorizar quais pipelines de automação construir ou executar primeiro, com base em qual pergunta analítica é mais urgente para um determinado caso de uso:
| Pergunta principal | Componente de pipeline mais relevante | Ferramenta de automação |
|---|---|---|
| Para que serve esta rede? (Objetivo) | Tarefas de categorização em lote | Classificação por LLM em relação aos esquemas do IAM / Social Change Map |
| Quem tem o que a rede precisa? (Recursos) | Similaridade semântica + percurso de relações | Embeddings do Nomic Atlas + percurso no Neo4j |
| O que funciona? (Ações) | Agregação de eventos de impacto | Consultas de agregação disparadas pelo n8n + registro de impacto |
| Quem se conecta a quem? (Estrutura) | Análise de centralidade de grafo | Biblioteca de algoritmos de grafo do Neo4j |
| Com o que as pessoas se importam? (Pessoas) | Agrupamento qualitativo | Nomic Atlas em campos narrativos/descritivos |
A dimensão dos diagnósticos visuais
O capítulo de Waddell situa o GRASP dentro de um conjunto mais amplo de métodos de diagnóstico visual — varreduras de questões (issue crawls), análise de redes sociais, análise de rede de valor, mapeamento conceitual e mapeamento geográfico — cada um adequado a diferentes aspectos da complexidade de rede. As funções de serviço descritas na Seção 5.5 se mapeiam diretamente sobre esses métodos:
- Descoberta e busca de entidades → análogo à varredura de questões (identificar quem está na arena)
- Percurso de relações → análise de redes sociais
- Consulta geográfica → mapeamento geográfico
- Similaridade semântica → mapeamento conceitual (revelando proximidade conceitual)
- Categorização e marcação → análise de rede de valor (atribuindo papéis e tipos de troca)
Esse alinhamento significa que a infraestrutura não é apenas um repositório de dados, mas uma plataforma para conduzir toda a gama de análise diagnóstica visual que Waddell descreve — com a vantagem significativa de que os dados são continuamente atualizados, em vez de coletados em uma pesquisa única. As redes podem ser analisadas em um ponto no tempo e depois reanalisadas periodicamente, tornando possível observar se as intervenções voltadas a lacunas estruturais estão tendo o efeito pretendido.
Servindo usuários, organizações e comunidades
A intenção prática de aplicar o GRASP por meio desta infraestrutura é melhorar três tipos de resultado, que correspondem aos três níveis da camada de Serviço:
Para usuários e contribuidores individuais: conectar pessoas a recursos, colaboradores e oportunidades que não teriam encontrado de forma independente. As funções de similaridade semântica e consulta geográfica são os mecanismos primários aqui. O objetivo é reduzir o atrito de coordenação que atualmente faz com que pessoas trabalhando em problemas semelhantes em redes adjacentes muitas vezes não se encontrem até anos depois de iniciarem seu trabalho, se é que se encontram.
Para organizações e projetos: ajudar a liderança a entender onde sua organização se posiciona na rede mais ampla, quais lacunas estruturais ela pode estar posicionada para preencher, e quais parceiros potenciais têm capacidades complementares. As funções de percurso de relações e categorização apoiam isso. O framework GRASP fornece a estrutura analítica que transforma esses pontos de dados em recomendações estratégicas, em vez de mera informação.
Para comunidades e ecossistemas: possibilitar o tipo de autocompreensão sistêmica que Waddell documenta como transformadora — na qual os participantes deixam de perguntar “o que eles podem me dar” e passam a perguntar “como o que eu faço pode fazê-los bem-sucedidos também?” A metodologia MfC alcança isso tornando todo o sistema visível a todos os seus participantes simultaneamente. Esta infraestrutura torna essa visibilidade persistente e atualizável, em vez de depender de um evento único de mapeamento participativo. Vale enfatizar que Waddell documenta essa autocompreensão sistêmica como o produto de processos participativos facilitados — varreduras de questões, convocações multissetoriais, facilitação qualificada ao longo do tempo. A infraestrutura fornece a camada de dados que torna esses processos mais informados e seus resultados mais duradouros. Ela não substitui os próprios processos.6
6. Referências
Esta seção lista as fontes primárias citadas ou utilizadas ao longo deste relatório, organizadas por categoria. As fontes são apresentadas em um formato apto para citação acadêmica ou profissional. URLs são fornecidas onde há versões de acesso aberto disponíveis.
6.1 Livros e Relatórios
Bauwens, M., & Niaros, V. (2016). Value in the commons economy: Developments in open and contributory value accounting. Heinrich Böll Foundation. https://www.boell.de/en/2017/02/01/value-commons-economy-developments-open-and-contributory-value-accounting
Conaty, P., & Bollier, D. (2016). Democratic money and capital for the commons. Commons Strategies Group / Heinrich Böll Foundation. https://www.boell.de/en/2016/01/15/democratic-money-and-capital-commons
Field, J. (2026, março). A digital nervous system for the wise web. Coasys. [Artigo do Medium] https://medium.com/coasys/a-digital-nervous-system-for-the-wise-web
Lightfoot, J. (2021). The liminal web: Mapping an emergent subculture of sensemakers, meta-theorists, and systems poets. joelightfoot.org. https://www.joelightfoot.org/post/the-liminal-web-mapping-an-emergent-subculture-of-sensemakers-meta-theorists-systems-poets
Nørgaard, B., Hedlund, N., & Meglin, C. (2025). Mapping an ecology of integrative approaches to addressing the metacrisis. Institute of Applied Metatheory. https://appliedmetatheory.org/mapping-ecology-integrative-approaches-addressing-metacrisis/
Nørgaard, B. (2025). Report on liminal web ecosystem networking and mapping. Institute of Applied Metatheory. https://coda.io/d/Report-on-Liminal-Web-Ecosystem-Networking-and-Mapping-public-ve_d1X6mvo57yO
Owocki, K. (2024). Onchain capital allocation handbook. Allo/Gitcoin. https://allobook.gitcoin.co
Owocki, K., Stringer, D., & Ospina, D. (2025). The networked firm: Capital allocation in the age of blockchain and AI. Allo Capital.
Power, S., & Seefeld, L. (2024). Bioregional financing facilities: Reimagining finance to regenerate our planet. BioFi Project / Dark Matter Capital Systems. https://www.biofi.earth
Smith, R. (2025). A sociology of big pictures: Network strategy for a 21st century worldview. Institute of Applied Metatheory. https://appliedmetatheory.org/a-sociology-of-big-pictures/
Waddell, S. (2011). Global action networks: Creating our future together. Palgrave Macmillan. [O Capítulo 4, “Seeing the Whole,” é a fonte primária do framework GRASP / Mapping for Clarity citado na Seção 5.6 deste relatório.]
6.2 Fontes de Dados e Mapas de Ecossistema
A seguir estão as principais fontes de dados e mapas de ecossistema referenciados na Seção 3. Descrições completas e métodos de acesso são fornecidos naquela seção; esta lista fornece referências em estilo de citação.
Bauwens, M. (Ed.). P2P Foundation Wiki. https://wiki.p2pfoundation.net [Em andamento; API MediaWiki disponível em wiki.p2pfoundation.net/api.php]
Berggruen Institute. Planetary Portal. https://planetaryportal.org
Bowen, C. Decentralized tech ecosystem map. Kumu. https://kumu.io/DigLife/decentralized-tech
Civic Hall. Civic Tech Guide. https://civictech.guide
de Graf, B. NooNAO. https://nao.is
de Graf, B., & Standingwave. Standingwave bioregional map. https://standingwave.net/apps/mapbox/
Ecovillage Network / Joubert, K. Global ecovillage map. https://ecovillage.org/ecovillages/map/
Iyer, D. The Social Change Map. https://www.socialchangemap.com
Life Itself. Second Renaissance ecosystem map. https://secondrenaissance.net/ecosystem/cohere/map
Lindenberger, D. Thaumazo community mycelium. https://thaumazo.org/projects/community-mycelium
National Civic League. Healthy Democracy Ecosystem Map. https://www.nationalcivicleague.org/2024-healthy-democracy/
One Earth. One Earth bioregion navigator. https://www.oneearth.org/navigator/
ReFi DAO. ReFi Ecosystem. https://www.refidao.com/ecosystem
Restor. Restor ecological restoration map. https://restor.eco
Roote. Wisdom Age. https://www.roote.co/wisdom-age
Schull, J. Big Map to Save the Future. https://bigmaptosavethefuture.net
Sloww. Meta-Crisis Meta-Resource. https://metacrisis.org
Terran Collective. Hylo. https://www.hylo.com
Weavers. Weavers Social Trust Map. https://trust.weavers.org
6.3 Ferramentas e Plataformas
As seguintes ferramentas e plataformas são referenciadas nas Seções 4 e 5. As referências são às páginas iniciais dos projetos e, quando disponível, à documentação técnica.
| Ferramenta / Plataforma | Papel no relatório | Referência |
|---|---|---|
| n8n | Orquestração de fluxo de trabalho (camadas de Ingestão / Normalização) | n8n.io · docs.n8n.io |
| Murmurations | Ingestão nativa de protocolo e federação | murmurations.network · docs.murmurations.network |
| Nomic Atlas | Geração de embeddings e agrupamento semântico | atlas.nomic.ai · docs.nomic.ai |
| Kumu | Visualização de grafos; fonte de exportação JSON | kumu.io · docs.kumu.io |
| HuViz | Interface de percurso de grafo RDF / SPARQL | smurp.github.io/huviz |
| Neo4j | Banco de dados de grafo (camada de Armazenamento, Opção A) | neo4j.com · neo4j.com/docs |
| SurrealDB | Banco de dados de grafo (camada de Armazenamento, Opção B) | surrealdb.com · surrealdb.com/docs |
| Apache AGE | Extensão de grafo para o Postgres (camada de Armazenamento, Opção C) | age.apache.org |
| Qdrant | Armazenamento vetorial (camada de Armazenamento, Opção A) | qdrant.tech · qdrant.tech/documentation |
| pgvector | Extensão vetorial do Postgres (camada de Armazenamento, Opção B) | github.com/pgvector/pgvector |
| Chroma | Armazenamento vetorial (camada de Armazenamento, Opção C) | trychroma.com |
| Pinecone | Armazenamento vetorial gerenciado (camada de Armazenamento, Opção D) | pinecone.io |
| Obsidian | Grafo de conhecimento pessoal; ferramenta de autoria para contribuidores | obsidian.md |
| Roam Research | Grafo de conhecimento pessoal; ferramenta de autoria para contribuidores | roamresearch.com |
| IAM Context | Mapeamento e categorização de estruturas conceituais | contextdriven.ai |
| ArcGIS / Esri | Camadas de dados geoespaciais; enriquecimento geográfico | esri.com/arcgis |
| Restor API | Dados de projetos baseados em território e restauração | restor.eco |
| OpenStreetMap Nominatim | Geocodificação (nível gratuito) | nominatim.openstreetmap.org |
| Make (Integromat) | Alternativa de orquestração de fluxo de trabalho em nuvem | make.com |
| Supabase | Postgres gerenciado (armazenamento de staging) | supabase.com |
| Fly.io | Implantação em nuvem; Postgres gerenciado | fly.io |
| RapidFuzz | Correspondência aproximada de strings em Python (deduplicação) | github.com/maxbachmann/RapidFuzz |
| sentence-transformers | Geração local de embeddings (Python) | sbert.net |
| Catalist | Plataforma de coordenação de rede; fonte de dados | catalist.network |
| Bright Data | Infraestrutura de scraping da web (se necessário em escala) | brightdata.com |
6.4 Padrões, Protocolos e Infraestrutura de Identidade
Os seguintes padrões e ferramentas de infraestrutura de identidade são referenciados no tratamento que o relatório dá à identidade digital, à prova de humanidade e à federação (Seções 2.6, 4.7 e 5.4).
W3C. (2022). Decentralized identifiers (DIDs) v1.0. https://www.w3.org/TR/did-core/
W3C. (2022). Verifiable credentials data model v1.1. https://www.w3.org/TR/vc-data-model/
W3C. (2017). Resource Description Framework (RDF). https://www.w3.org/RDF/
W3C. (2013). SPARQL 1.1 query language. https://www.w3.org/TR/sparql11-query/
W3C. (2017). Shapes Constraint Language (SHACL). https://www.w3.org/TR/shacl/
Murmurations Protocol. Murmurations network index and profile schema specification. https://murmurations.network
SpruceID. Open-source DID and verifiable credentials tooling. https://spruceid.com
Veramo. JavaScript framework for DIDs and verifiable credentials. https://veramo.io
Solid Project. Personal data pods specification (Berners-Lee). https://solidproject.org
cheqd. Blockchain-based credential network. https://cheqd.io
6.5 Frameworks de Medição de Impacto
Os seguintes frameworks são referenciados no tratamento que o relatório dá à medição de impacto multidimensional (Seções 2.5 e 4.7).
Global Impact Investing Network (GIIN). IRIS+ impact measurement system. https://iris.thegiin.org
United Nations. Sustainable Development Goals (SDGs). https://sdgs.un.org/goals
R3.0. (2020). From monocapitalism to multicapitalism: 21st century system value creation (Baue, W.). https://www.r3-0.org
6.6 Principais Organizações e Iniciativas Referenciadas
As seguintes organizações e iniciativas são citadas neste relatório no contexto de casos de uso, parcerias de dados ou relações de ecossistema. Esta lista é fornecida como referência; não é exaustiva.
| Organização / Iniciativa | Papel no relatório | URL |
|---|---|---|
| Institute of Applied Metatheory (IAM) | Patrocinador da pesquisa original de mapeamento da web liminal; taxonomia de ecologia de metacrise do IAM; plataforma Context | appliedmetatheory.org |
| Eudaimonia Institute | Parceiro operacional; Strategic Metacrisis Mapping Initiative | eudaimoniainstitute.org |
| Civilization Research Institute (CRI) | Pesquisa sobre metacrise; possível conexão com o caso de uso 2.5 | civilizationresearchinstitute.org |
| OpenHaven | Caso de uso primário (mapeamento de tecnologia DWeb / P2P) | openhaven.net |
| Better Together America (BTA) | Rede de hubs cívicos; caso de uso primário (camada de coordenação cívica) | bettertogetheramerica.org |
| Mediators Foundation (MF) | Parceiro institucional para a Civic Intelligence Infrastructure | mediatorsfoundation.org |
| Life Itself | Second Renaissance ecosystem map; plataforma Cohere | secondrenaissance.net |
| Coasys | Runtime de web semântica AD4M | github.com/coasys/ad4m |
| BioFi Project | Framework e ferramentas de Bioregional Financing Facilities | biofi.earth |
| MetaGov | Pesquisa em governança digital; parceiro do ecossistema CII | metagov.org |
| Hylo / Terran Collective | Fonte de dados Nível 1; API GraphQL; plataforma comunitária regenerativa | hylo.com |
| National Civic League | Healthy Democracy Ecosystem Map; esquema de categorização | nationalcivicleague.org |
| P2P Foundation | Fonte de dados Nível 1; API MediaWiki; Michel Bauwens | wiki.p2pfoundation.net |
| NooNAO / Brad de Graf | Mapeamento biorregional; rede World Wise Web | nao.is |
| Thaumazo | Micélio comunitário biorregional; fonte de dados de parceria | thaumazo.org |
Footnotes
-
Este documento descreve quais dados fluem por um pipeline e quais funções esse pipeline pode servir. Não modela por que os atores mudariam seu comportamento por terem acesso a essas funções, quem faria o trabalho de facilitação de agir sobre os dados, ou como o engajamento sustentado dos contribuidores seria alcançado e mantido. Essas não são questões técnicas — são questões organizacionais e relacionais. Os documentos complementares as abordam diretamente: a Infraestrutura de Mapeamento deve ser lida em conjunto com a Taxonomia de Referência de Financiamento entre Pares e Finanças Baseadas em Bens Comuns e com o documento complementar Financiando os Bens Comuns na Prática, que juntos tratam da camada de coordenação humana que esta arquitetura exige. ↩
-
O ecossistema da web liminal e da tecnologia cívica já foi mapeado várias vezes: o mapa Liminal Web de Joe Lightfoot (2021), o Second Renaissance Ecosystem Map da Life Itself, a Ecology of Integrative Approaches do IAM, o Catalist, o Hylo e o NooNAO existem, todos parcial ou totalmente acessíveis ao público. As lacunas de coordenação descritas neste caso de uso persistiram apesar desses recursos. Isso não significa que a infraestrutura de mapeamento não tenha valor — significa que a infraestrutura sozinha não é suficiente, e que a restrição limitante é mais provavelmente a camada de facilitação do que a camada de dados. A pergunta a se manter é: o que os coordenadores fariam de diferente com essa infraestrutura que não estão fazendo agora, e o que os impede de fazer isso hoje? ↩
-
O cenário descrito neste caso de uso — organizações colocalizadas sem consciência umas das outras — está se tornando menos comum à medida que as redes regenerativas regionais amadurecem. As falhas de coordenação mais típicas em ecossistemas regenerativos são: competição por recursos entre organizações que se candidatam aos mesmos financiadores com escopos sobrepostos; incompatibilidade de governança entre grupos com culturas de tomada de decisão diferentes; e desacordo substantivo sobre teorias de manejo da terra, soberania sobre o conhecimento indígena, ou prática regenerativa, que não são resolvidos pela mera consciência mútua. Uma infraestrutura que torna essas tensões mais claramente visíveis é valiosa — mas deve ser entendida como algo que torna conflitos existentes legíveis, e não que os dissolve. ↩
-
A análise de Steve Waddell sobre Redes de Ação Global em Global Action Networks: Creating Our Future Together (2011) documenta organizações como a Global Reporting Initiative, o Forest Stewardship Council e o Marine Stewardship Council. Essas redes emergiram de anos de engajamento multissetorial sustentado, construção diplomática de relacionamentos e desenvolvimento organizacional — não de uma melhor descobribilidade de dados. A infraestrutura de mapeamento descrita neste documento pode apoiar a formação de GANs ao tornar os participantes potenciais visíveis uns aos outros e ao fornecer infraestrutura analítica compartilhada. Ela não pode substituir o trabalho relacional e político que Waddell identifica como o mecanismo real do surgimento das GANs. Este caso de uso deve ser entendido como uma aspiração de longo horizonte, dependente de investimento substancial em facilitação, e não como um resultado de infraestrutura de curto prazo. ↩
-
A afirmação de que a infraestrutura pode identificar quais intervenções abordam causas versus sintomas implica um nível de conhecimento causal sobre sistemas complexos que atualmente não existe como um artefato computável. A classificação baseada em LLM em relação a esquemas de categorização — o mecanismo descrito na camada de Enriquecimento — pode identificar como os atores descrevem e enquadram seu próprio trabalho, e pode revelar convergências e divergências em como diferentes esquemas categorizam a mesma entidade. Não pode arbitrar entre teorias concorrentes de mudança nem determinar caminhos causais reais em sistemas sociais complexos. A linguagem revisada no texto principal (“enquadradas como abordando causas versus sintomas pelos atores e esquemas representados nos dados”) reflete o que o sistema pode de fato produzir. ↩
-
A mudança que Waddell documenta — de “o que eles podem me dar” para “como o que eu faço pode fazê-los bem-sucedidos também” — é descrita em Global Action Networks como o produto do que ele chama de processos “Mapping for Clarity”: engajamentos multissetoriais estruturados e facilitados, nos quais todos os participantes veem o sistema inteiro simultaneamente e trabalham juntos os elementos do GRASP. Não são sessões de análise de dados — são processos relacionais e deliberativos que por acaso são informados por dados. A infraestrutura descrita neste documento torna esses processos analiticamente mais rigorosos e seus resultados mais persistentes e atualizáveis. Ela não os torna menos necessários. ↩